Available immediately · Barcelona · open to relocateDisponible de inmediato · Barcelona · abierto a reubicarmeDisponible immediatament · Barcelona · obert a canviar de ciutat可立即到岗 · 巴塞罗那 · 可考虑搬迁
Hi, I'm Hang YaoHola, soy Hang YaoHola, sóc Hang Yao你好,我是姚航
>Data & Software Engineer
I build data pipelines, backend services and AI systems.Construyo pipelines de datos, servicios backend y sistemas de IA.Construeixo pipelines de dades, serveis backend i sistemes d'IA.我构建数据流水线、后端服务和 AI 系统。
MSc Data Science · UPCMáster en Data Science · UPCMàster en Data Science · UPCUPC 数据科学硕士
EN · ES · CA · 中文
ask-hang · cv assistant
who is hang?¿quién es hang?qui és hang?姚航是谁?
Data & Software Engineer · MSc Data Science (UPC) · 17 months building banking microservices at NTT DATA.Ingeniero de Datos y Software · Máster en Data Science (UPC) · 17 meses construyendo microservicios bancarios en NTT DATA.Enginyer de Dades i Programari · Màster en Data Science (UPC) · 17 mesos construint microserveis bancaris a NTT DATA.数据与软件工程师 · UPC 数据科学硕士 · 在 NTT DATA 为银行客户构建微服务 17 个月。
what has he built?¿qué ha construido?què ha construït?他做过什么?
can he work in spain?¿puede trabajar en españa?pot treballar a espanya?能在西班牙工作吗?
Yes — Spanish work permit, no sponsorship needed.Sí — permiso de trabajo en España, sin sponsorship.Sí — permís de treball a Espanya, sense sponsorship.可以——持西班牙工作许可,无需担保。
150k+API records modeledregistros de API modeladosregistres d'API modelats建模的 API 记录
10 GBheterogeneous data integrateddatos integradosdades integrades集成的多源数据
~90%test coverage sustainedcobertura de testscobertura de tests测试覆盖率
01 / profileperfilperfil简介
AboutSobre míSobre mi关于我
Data & Software Engineer with a BSc in Computer Science and an MSc in Data Science, plus enterprise experience at NTT DATA building production microservices for a banking client. Comfortable across the full development lifecycle — REST APIs, relational databases, automated testing and CI/CD in an agile team — and across modern data work, from scalable pipelines and cloud warehouses to machine learning and AI systems. Strong on turning complex problems into reliable, deployed solutions, with a habit of validating and measuring what I build.Ingeniero de Datos y Software con un Grado en Ingeniería Informática y un Máster en Data Science, además de experiencia empresarial en NTT DATA construyendo microservicios en producción para un cliente bancario. Me muevo con soltura en todo el ciclo de desarrollo — APIs REST, bases de datos relacionales, testing automatizado y CI/CD en un equipo ágil — y en el trabajo de datos moderno, desde pipelines escalables y data warehouses en cloud hasta machine learning y sistemas de IA. Fuerte en convertir problemas complejos en soluciones fiables y desplegadas, con la costumbre de validar y medir lo que construyo.Enginyer de Dades i Programari amb un Grau en Enginyeria Informàtica i un Màster en Data Science, a més d'experiència empresarial a NTT DATA construint microserveis en producció per a un client bancari. Em moc amb soltesa en tot el cicle de desenvolupament — APIs REST, bases de dades relacionals, testing automatitzat i CI/CD en un equip àgil — i en la feina de dades moderna, des de pipelines escalables i data warehouses al núvol fins a machine learning i sistemes d'IA. Fort a convertir problemes complexos en solucions fiables i desplegades, amb l'hàbit de validar i mesurar el que construeixo.数据与软件工程师,拥有计算机科学学士与数据科学硕士学位,并在 NTT DATA 为银行客户构建生产级微服务。熟悉完整开发生命周期——REST API、关系型数据库、自动化测试与 CI/CD,敏捷团队协作——同时覆盖现代数据工作,从可扩展流水线与云数据仓库到机器学习与 AI 系统。擅长把复杂问题转化为可靠、可部署的方案,并习惯于验证和度量自己构建的东西。
Data EngineeringIngeniería de datosEnginyeria de dades数据工程
Batch and streaming pipelines, lakehouses and cloud warehouses that stay correct and cheap to query.Pipelines batch y streaming, lakehouses y data warehouses en cloud: correctos y baratos de consultar.Pipelines batch i streaming, lakehouses i data warehouses al núvol: correctes i barats de consultar.批处理与流式流水线、数据湖仓与云数仓——既准确又查询高效。
SparkKafkaAirflowBigQuery
Backend & SoftwareBackend y softwareBackend i programari后端与软件
REST APIs and microservices with automated tests and CI/CD — from a banking client to my own deployed services.APIs REST y microservicios con tests automatizados y CI/CD — desde un cliente bancario hasta servicios propios desplegados.APIs REST i microserveis amb tests automatitzats i CI/CD — des d'un client bancari fins a serveis propis desplegats.带自动化测试与 CI/CD 的 REST API 与微服务——从银行客户项目到自己部署的服务。
Spring BootFastAPINode.jsGitHub Actions
AI & MLIA y MLIA i MLAI 与机器学习
LLMs, RAG and vision-language models — benchmarked and validated, not just demoed.LLMs, RAG y modelos visión-lenguaje — evaluados y validados, no solo demos.LLMs, RAG i models de visió i llenguatge — avaluats i validats, no només demos.大语言模型、RAG 与视觉语言模型——经过基准评测与验证,而不只是演示。
PyTorchHugging FaceFAISSQwen
02 / journeytrayectoriatrajectòria经历
Experience & EducationExperiencia y formaciónExperiència i formació工作与教育经历
My work and studies, side by side.Mi trabajo y mis estudios, en paralelo.La meva feina i els meus estudis, en paral·lel.我的工作与学习经历。
NTT DATA · Barcelona · NTT Group (Fortune Global 500)Barcelona · Grupo NTT (Fortune Global 500)Barcelona · Grup NTT (Fortune Global 500)巴塞罗那 · 世界500强 NTT 集团旗下
Developed enterprise-grade microservices and state-driven workflows with the Spring ecosystem to securely route and process financial records for a major banking client, working across design, development, delivery and maintenance.
Desarrollé microservicios de nivel empresarial y flujos basados en estados con el ecosistema Spring para encaminar y procesar de forma segura registros financieros de un gran cliente bancario, participando en diseño, desarrollo, entrega y mantenimiento.
Vaig desenvolupar microserveis de nivell empresarial i fluxos basats en estats amb l'ecosistema Spring per encaminar i processar de manera segura registres financers d'un gran client bancari, participant en el disseny, el desenvolupament, el lliurament i el manteniment.
使用 Spring 生态开发企业级微服务与状态驱动的工作流,为大型银行客户安全地路由和处理金融记录,参与设计、开发、交付与维护全过程。
Designed and consumed REST APIs between services, modelling application state onto custom relational database schemas to guarantee reliable data persistence.
Diseñé y consumí APIs REST entre servicios, modelando el estado de la aplicación sobre esquemas relacionales a medida para garantizar una persistencia de datos fiable.
Vaig dissenyar i consumir APIs REST entre serveis, modelant l'estat de l'aplicació sobre esquemes relacionals a mida per garantir una persistència de dades fiable.
Wrote and maintained unit tests with JUnit, sustaining ~90% coverage on core modules, and set up CI/CD pipelines with GitHub Actions; diagnosed and resolved production incidents under strict financial-data compliance.
Escribí y mantuve tests unitarios con JUnit, sosteniendo ~90% de cobertura en los módulos principales, y monté pipelines de CI/CD con GitHub Actions; diagnostiqué y resolví incidencias de producción bajo estrictos requisitos de cumplimiento con datos financieros.
Vaig escriure i mantenir tests unitaris amb JUnit, sostenint ~90% de cobertura als mòduls principals, i vaig muntar pipelines de CI/CD amb GitHub Actions; vaig diagnosticar i resoldre incidències de producció sota requisits estrictes de compliment amb dades financeres.
Worked in an agile team with code review and version control (Git), and modernised legacy multi-layer frameworks without disrupting existing functionality.
Trabajé en un equipo ágil con revisión de código y control de versiones (Git), y modernicé frameworks heredados multicapa sin afectar la funcionalidad existente.
Vaig treballar en un equip àgil amb revisió de codi i control de versions (Git), i vaig modernitzar frameworks heretats multicapa sense afectar la funcionalitat existent.
MSc Data ScienceMáster en Data ScienceMàster en Data Science数据科学硕士
Universitat Politècnica de Catalunya (UPC) · QS Eng. & Tech. #96 · QS 工程与技术全球第96
During the master'sDurante el másterDurant el màster硕士期间2025.09 – 2026.01Exchange Student (Master's)Estudiante de Intercambio (Máster)Estudiant d'Intercanvi (Màster)硕士交换生Beihang University · Beijing · China's top-10 in engineeringUniversidad de Beihang · Pekín · top-10 de China en ingenieríaUniversitat de Beihang · Pequín · top-10 de la Xina en enginyeria北京航空航天大学 · 北京
2020.09 – 2024.06
BSc Computer ScienceGrado en Ingeniería InformáticaGrau en Enginyeria Informàtica计算机科学学士
Universitat Politècnica de Catalunya (UPC)
03 / work samplesmuestrasmostres作品
ProjectsProyectosProjectes项目
Filter by area, open a project to see its architecture, or ask the AI about it.Filtra por área, abre un proyecto para ver su arquitectura o pregúntale a la IA.Filtra per àrea, obre un projecte per veure'n l'arquitectura o pregunta-ho a la IA.按方向筛选,打开项目查看架构,或直接问 AI。
10 GBintegrated across cold, warm and hot pathsintegrados por caminos cold, warm y hotintegrats pels camins cold, warm i hot经冷/温/热三条链路集成
lakehouse★ FeaturedDestacadoDestacat精选
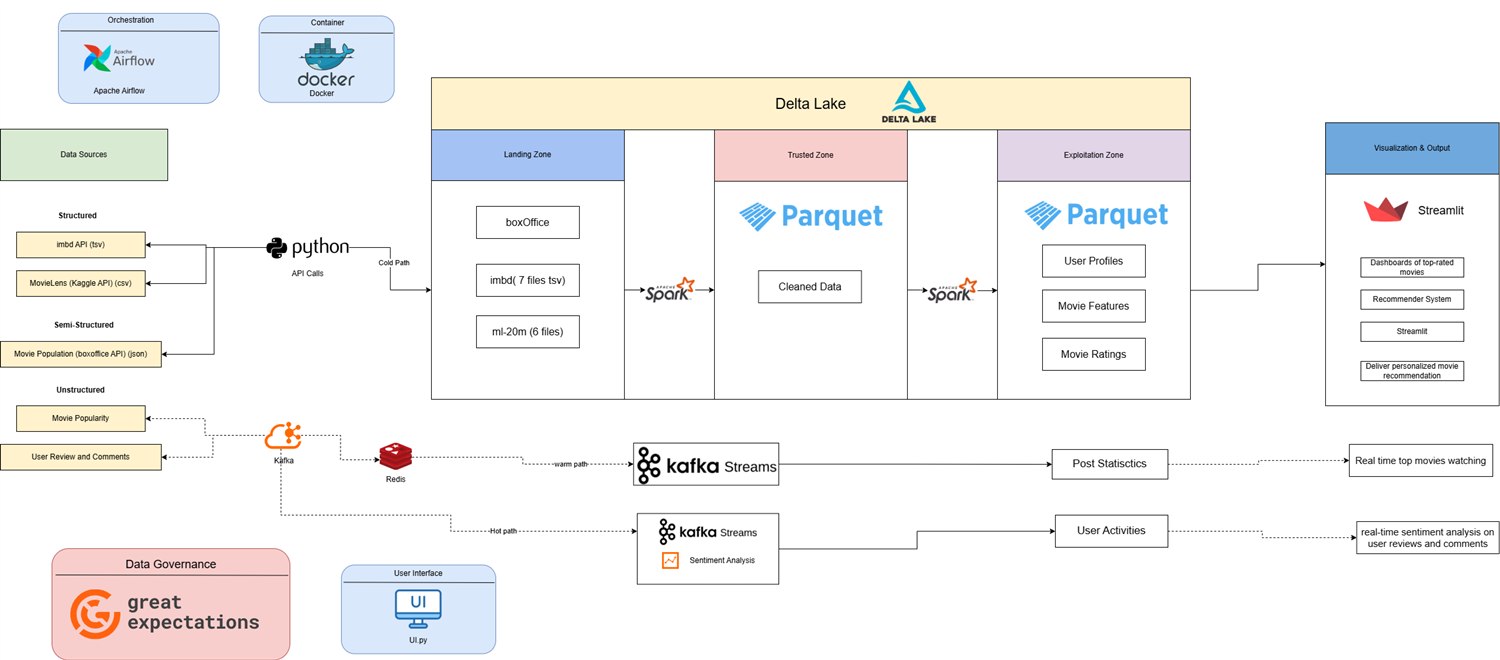
Containerized Cold/Warm/Hot lakehouse integrating 10 GB of sources with Spark, Kafka and Redis, orchestrated by Airflow on Delta Lake.Lakehouse Cold/Warm/Hot en contenedores que integra 10 GB de fuentes con Spark, Kafka y Redis, orquestado con Airflow sobre Delta Lake.Lakehouse Cold/Warm/Hot en contenidors que integra 10 GB de fonts amb Spark, Kafka i Redis, orquestrat amb Airflow sobre Delta Lake.容器化的冷/温/热数据湖仓,用 Spark、Kafka 与 Redis 集成 10GB 数据,基于 Delta Lake 并由 Airflow 编排。
SparkKafkaAirflowDocker+1
HighlightsPuntos clavePunts clau要点
Containerized 3-tier (Cold/Warm/Hot) lakehouse on Docker, integrating 10 GB of heterogeneous sources via REST APIs with Spark, Kafka and Redis; daily ETL orchestrated with Airflow.
Data lakehouse de 3 niveles en Docker, integrando 10 GB de fuentes vía REST APIs con Spark, Kafka y Redis; ETL diario orquestado con Airflow.
Data lakehouse de 3 nivells en Docker, integrant 10 GB de fonts via REST APIs amb Spark, Kafka i Redis; ETL diari orquestrat amb Airflow.
architecture — cold/hot/warm ingestion · Landing → Trusted → Exploitation zones on Delta Lake · Airflow + Docker
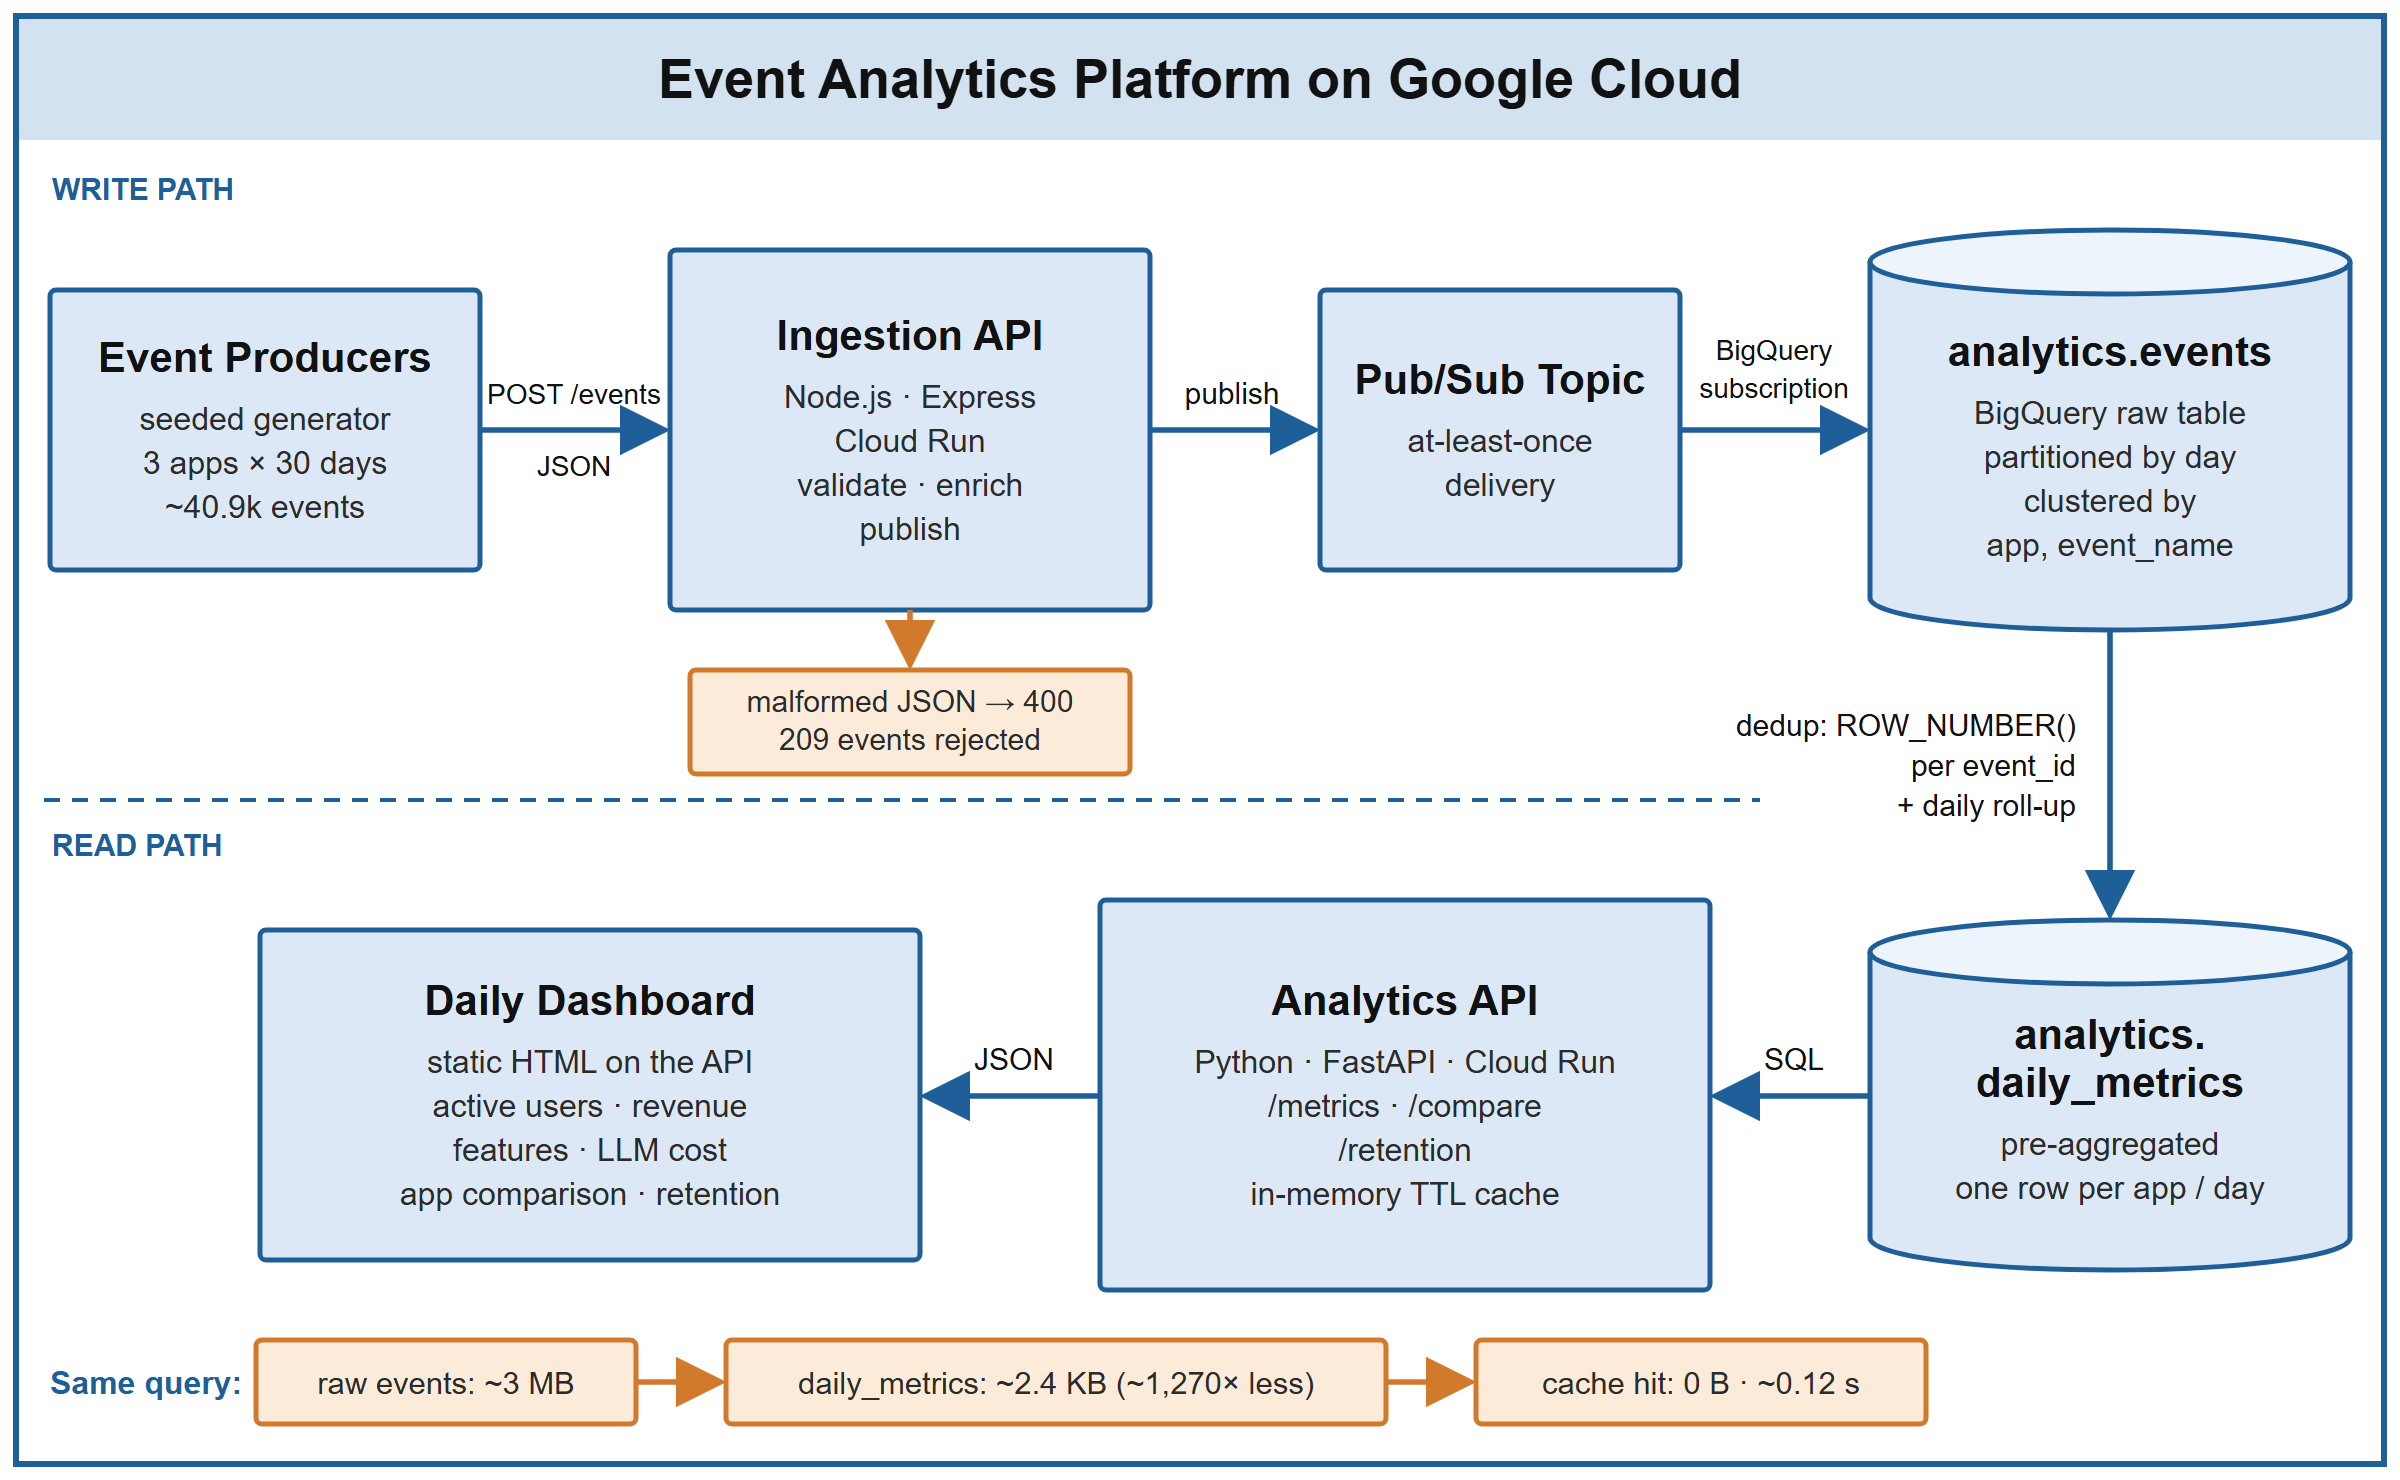
3 MB → 2.4 KBscanned per query after pre-aggregationescaneado por consulta tras la preagregaciónescanejat per consulta després de la preagregació预聚合后单次查询的扫描量
Two Cloud Run services stream events through Pub/Sub into BigQuery; dedup, caching and pre-aggregation cut a query from ~3 MB to ~2.4 KB.Dos servicios en Cloud Run llevan eventos vía Pub/Sub a BigQuery; deduplicación, caché y preagregación bajan una consulta de ~3 MB a ~2,4 KB.Dos serveis a Cloud Run porten esdeveniments via Pub/Sub a BigQuery; deduplicació, memòria cau i preagregació redueixen una consulta de ~3 MB a ~2,4 KB.两个 Cloud Run 服务经 Pub/Sub 将事件流式写入 BigQuery;去重、缓存与预聚合把一次查询从约 3 MB 降到约 2.4 KB。
GCPPub/SubBigQueryCloud Run+2
HighlightsPuntos clavePunts clau要点
Designed and deployed two services end to end on Cloud Run: a Node.js/Express ingestion API that validates, enriches and publishes incoming events to Pub/Sub, and a Python/FastAPI analytics API serving metrics over HTTP from BigQuery.
Diseñé y desplegué dos servicios de extremo a extremo en Cloud Run: una API de ingesta en Node.js/Express que valida, enriquece y publica los eventos entrantes en Pub/Sub, y una API analítica en Python/FastAPI que sirve métricas por HTTP desde BigQuery.
Vaig dissenyar i desplegar dos serveis d'extrem a extrem a Cloud Run: una API d'ingesta en Node.js/Express que valida, enriqueix i publica els esdeveniments entrants a Pub/Sub, i una API analítica en Python/FastAPI que serveix mètriques per HTTP des de BigQuery.
在 Cloud Run 上端到端设计并部署两个服务:Node.js/Express 接入 API 负责校验、丰富并将事件发布到 Pub/Sub;Python/FastAPI 分析 API 通过 HTTP 从 BigQuery 提供指标。
Built in reliability and cost controls: rejected malformed records at the edge, deduplicated at-least-once deliveries at query time, and added caching plus pre-aggregation that cut a representative query from ~3 MB scanned to ~2.4 KB.
Incorporé controles de fiabilidad y coste: rechazo de registros malformados en el borde, deduplicación de entregas at-least-once en la consulta, y caché más preagregación que redujeron una consulta representativa de ~3 MB escaneados a ~2,4 KB.
Vaig incorporar controls de fiabilitat i cost: rebuig de registres malformats a l'entrada, deduplicació de lliuraments at-least-once en la consulta, i memòria cau més preagregació que van reduir una consulta representativa de ~3 MB escanejats a ~2,4 KB.
9/10LLM-as-a-Judge score vs TextRank & BARTpuntuación LLM-as-a-Judge frente a TextRank y BARTpuntuació LLM-as-a-Judge davant de TextRank i BARTLLM-as-a-Judge 评分,对比 TextRank 与 BART
rag · nlp
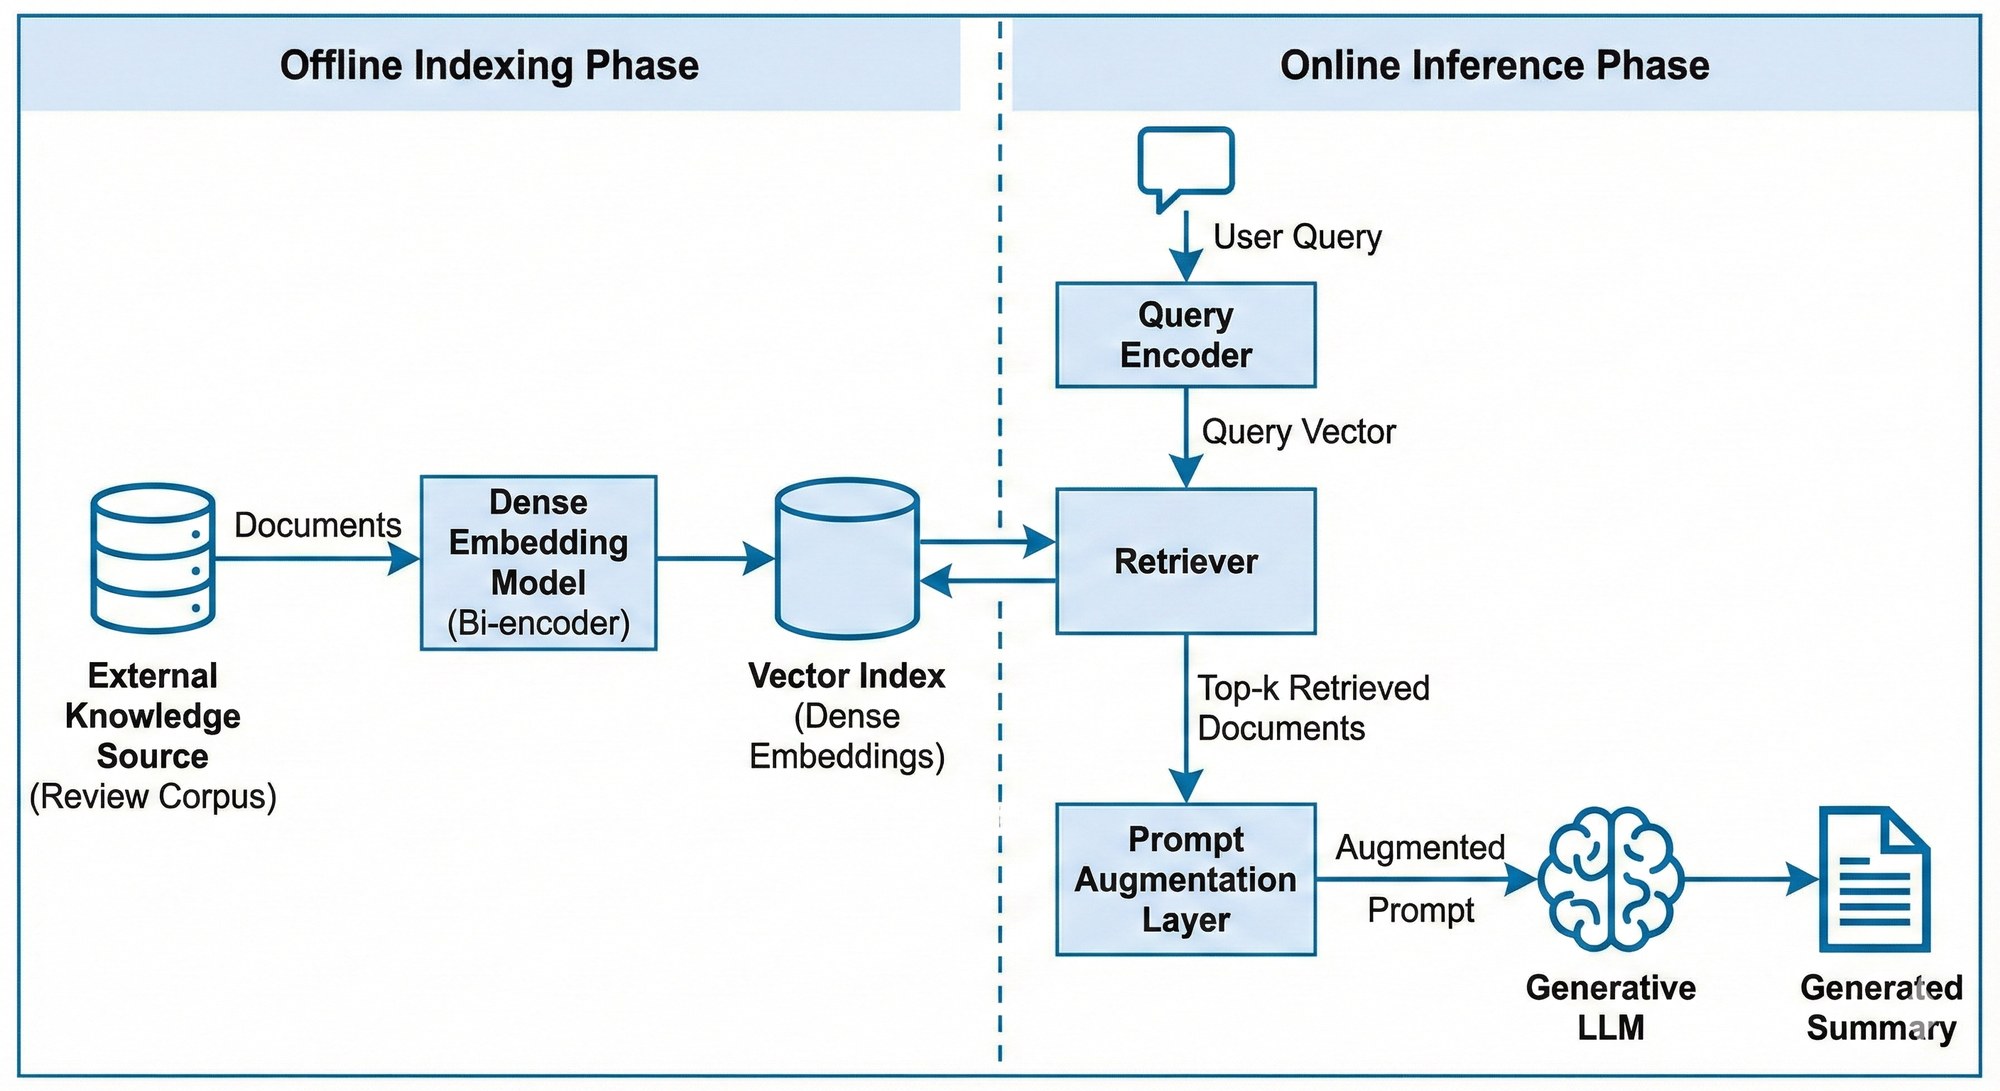
Query-focused summaries of large-scale e-commerce reviews with dense retrieval and a quantized Qwen3 generator — 9/10 vs TextRank and BART.Resúmenes guiados por consulta de reseñas de e-commerce a gran escala, con recuperación densa y un generador Qwen3 cuantizado — 9/10 frente a TextRank y BART.Resums guiats per consulta de ressenyes d'e-commerce a gran escala, amb recuperació densa i un generador Qwen3 quantitzat — 9/10 davant de TextRank i BART.基于稠密检索与量化 Qwen3 生成器,对大规模电商评论生成面向查询的摘要——对比 TextRank 与 BART 得 9/10。
RAGFAISSHugging FaceQwen3+1
HighlightsPuntos clavePunts clau要点
RAG pipeline over large-scale e-commerce reviews: sentence-transformers embeddings + FAISS dense retrieval feeding a 4-bit quantized Qwen3-4B-Instruct generator for efficient local inference.
Pipeline RAG sobre reseñas de e-commerce a gran escala: embeddings con sentence-transformers + recuperación densa con FAISS que alimentan un generador Qwen3-4B-Instruct cuantizado a 4-bit para inferencia local eficiente.
Pipeline RAG sobre ressenyes d'e-commerce a gran escala: embeddings amb sentence-transformers + recuperació densa amb FAISS que alimenten un generador Qwen3-4B-Instruct quantitzat a 4 bits per a inferència local eficient.
Benchmarked against TextRank and BART baselines on Amazon Reviews and SAMSum with ROUGE and an LLM-as-a-Judge protocol; RAG scored 9/10, synthesizing conflicting opinions where baselines hallucinated.
Comparado con TextRank y BART en Amazon Reviews y SAMSum con ROUGE y un protocolo LLM-as-a-Judge; RAG obtuvo 9/10, sintetizando opiniones contradictorias donde los baselines alucinaban.
Comparat amb TextRank i BART a Amazon Reviews i SAMSum amb ROUGE i un protocol LLM-as-a-Judge; RAG va obtenir 9/10, sintetitzant opinions contradictòries on els baselines al·lucinaven.
Vue 3 + Appwritecollaborative review app with role-based accessapp de revisión colaborativa con acceso por rolesapp de revisió col·laborativa amb accés per rols带角色权限的协作评审应用
full-stack
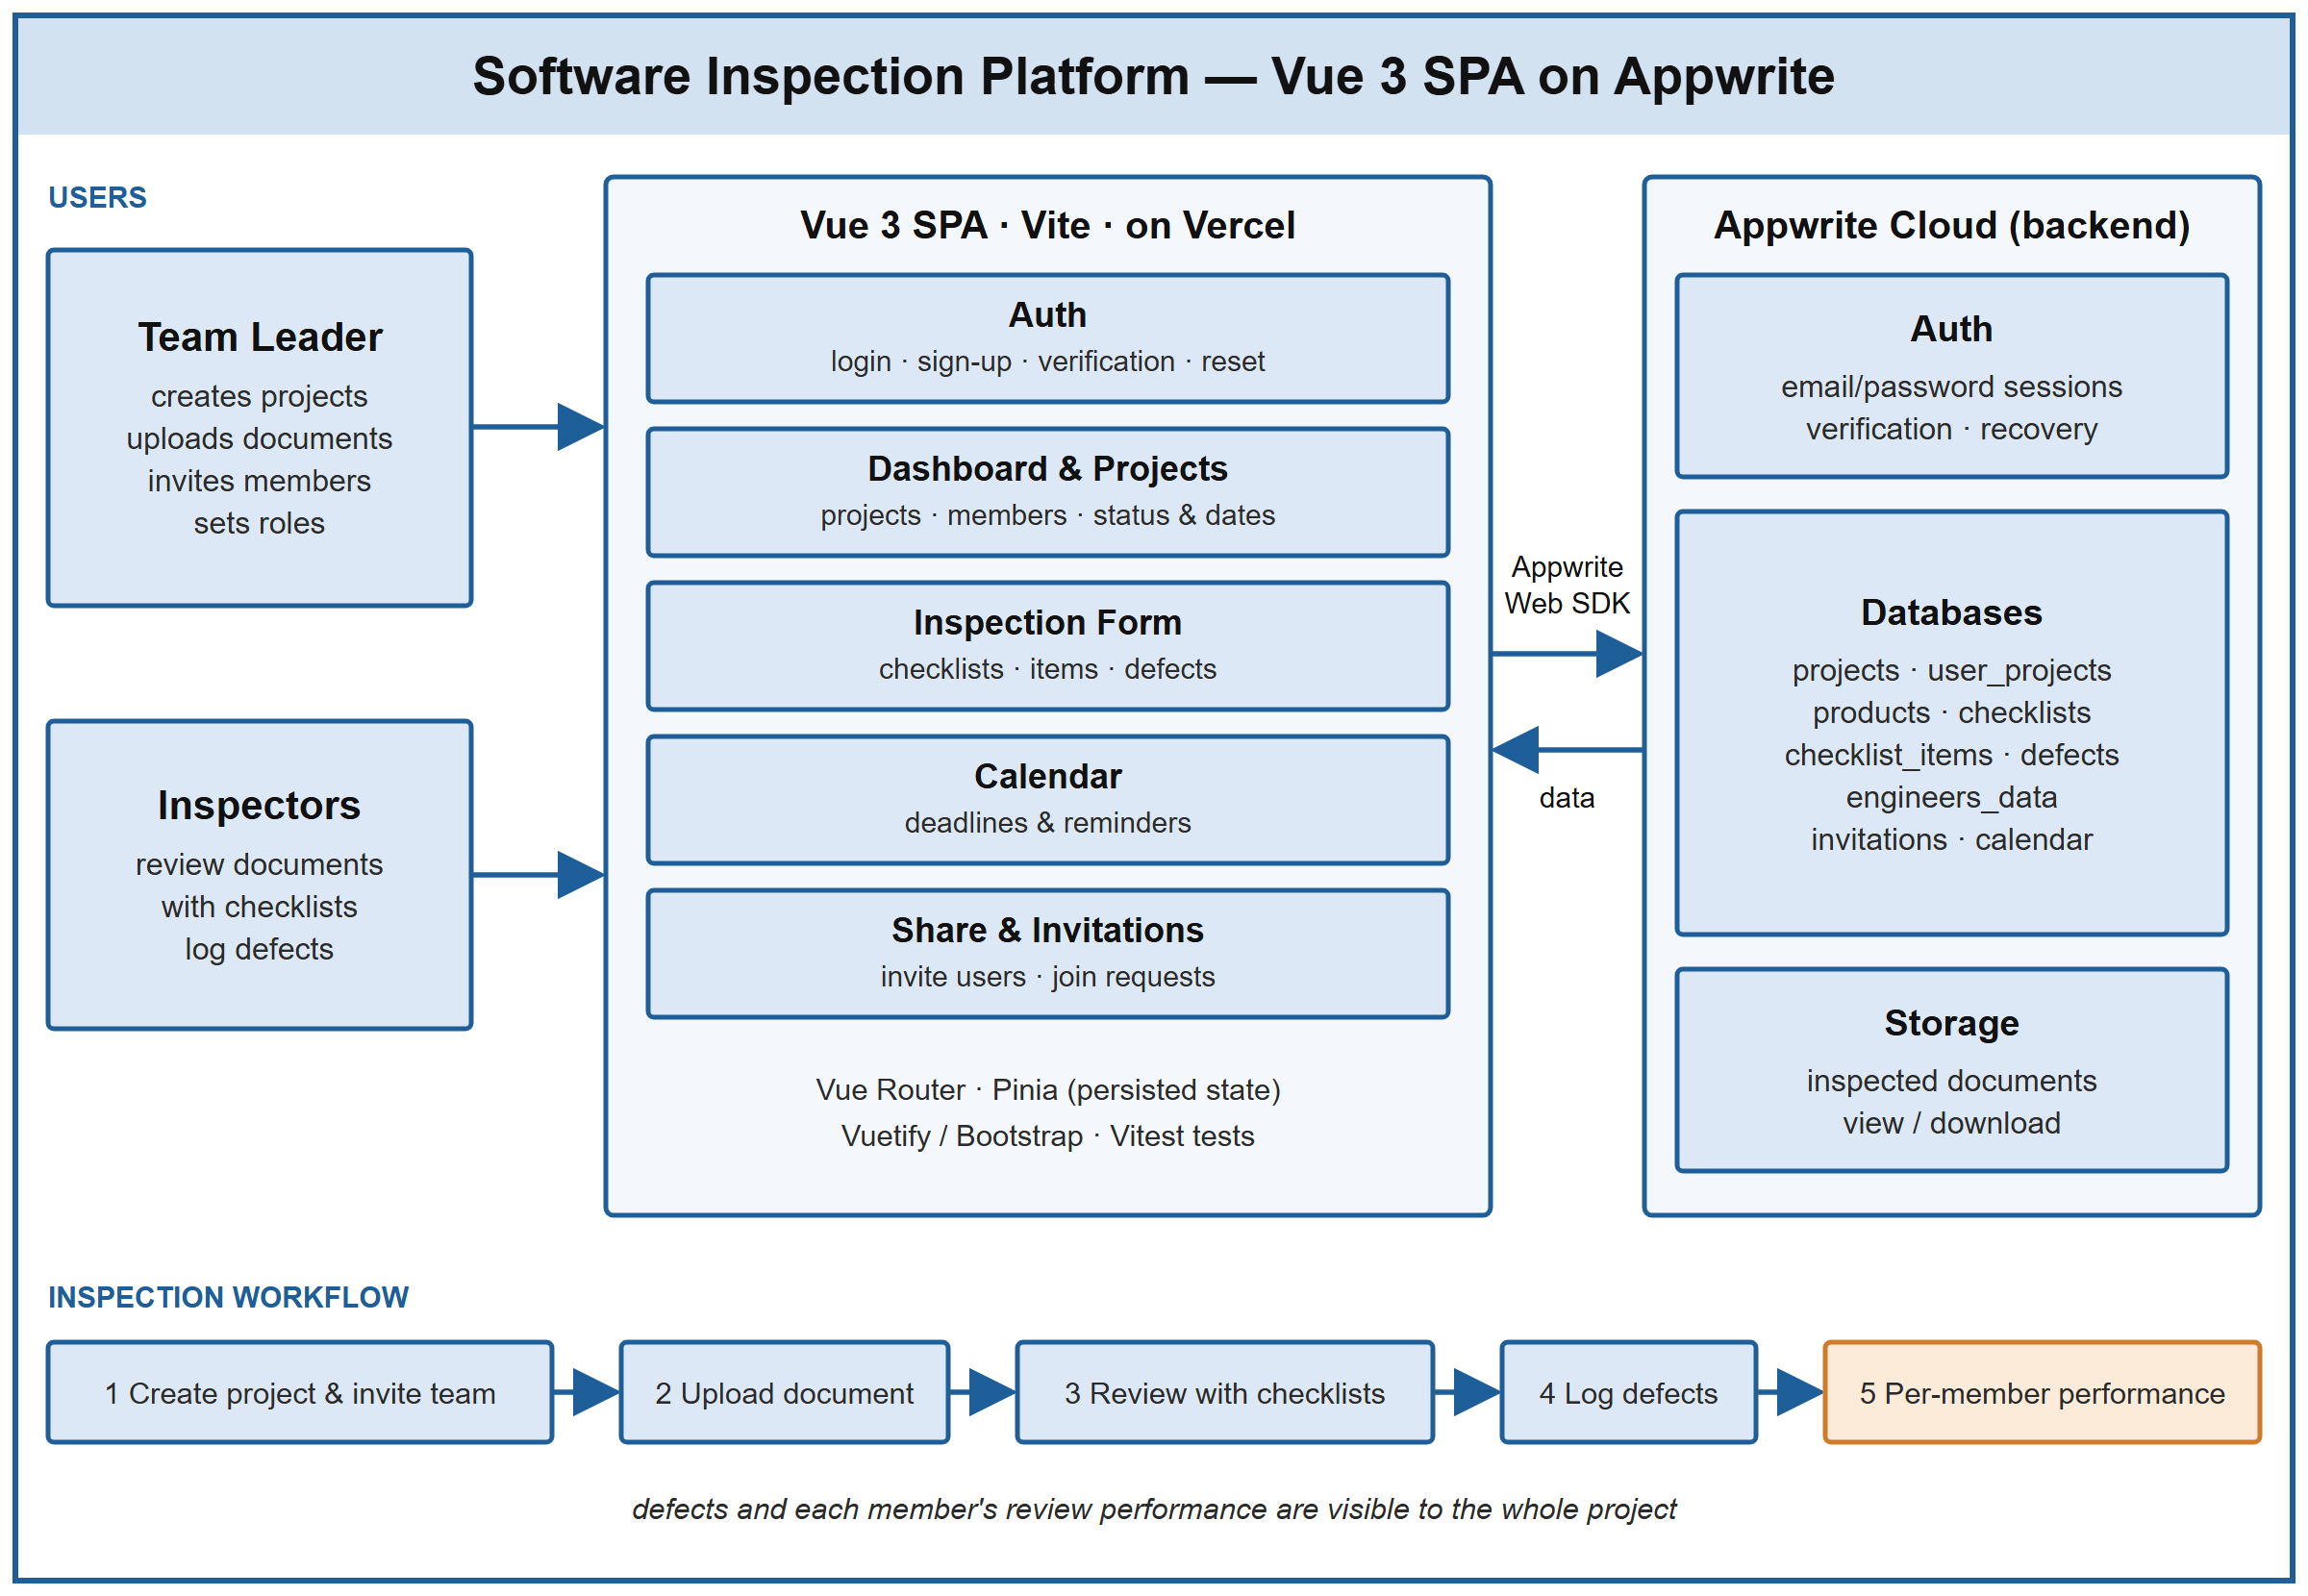
Collaborative app where teams review documents, log defects and track per-member performance — Vue 3 on Appwrite.App colaborativa donde los equipos revisan documentos, registran defectos y siguen el rendimiento por miembro — Vue 3 sobre Appwrite.App col·laborativa on els equips revisen documents, registren defectes i fan el seguiment del rendiment per membre — Vue 3 sobre Appwrite.团队协作评审文档、记录缺陷并追踪每位成员表现的应用——基于 Appwrite 的 Vue 3。
Vue.jsJavaScriptAppwritePinia+1
HighlightsPuntos clavePunts clau要点
Collaborative web app where users log in, join teams, and review documents submitted by a team leader — with defects and per-member review performance visible to the whole project.
App web colaborativa donde los usuarios inician sesión, se unen a equipos y revisan documentos enviados por un líder — con defectos y rendimiento por miembro visibles para todo el proyecto.
App web col·laborativa on els usuaris inicien sessió, s'uneixen a equips i revisen documents enviats per un líder — amb defectes i rendiment per membre visibles per a tot el projecte.
协作式 Web 应用:用户登录、加入团队、评审组长提交的文档——缺陷与每位成员的评审表现对全项目可见。
Built the Vue 3 single-page app (Vite, Vue Router, Pinia) on Appwrite as a backend-as-a-service, calling its SDK for authentication, the project database, document storage and role-based access across teams.
Desarrollé la SPA en Vue 3 (Vite, Vue Router, Pinia) sobre Appwrite como backend-as-a-service, usando su SDK para autenticación, la base de datos del proyecto, el almacenamiento de documentos y el acceso por roles entre equipos.
Vaig desenvolupar la SPA en Vue 3 (Vite, Vue Router, Pinia) sobre Appwrite com a backend-as-a-service, fent servir el seu SDK per a l'autenticació, la base de dades del projecte, l'emmagatzematge de documents i l'accés per rols entre equips.
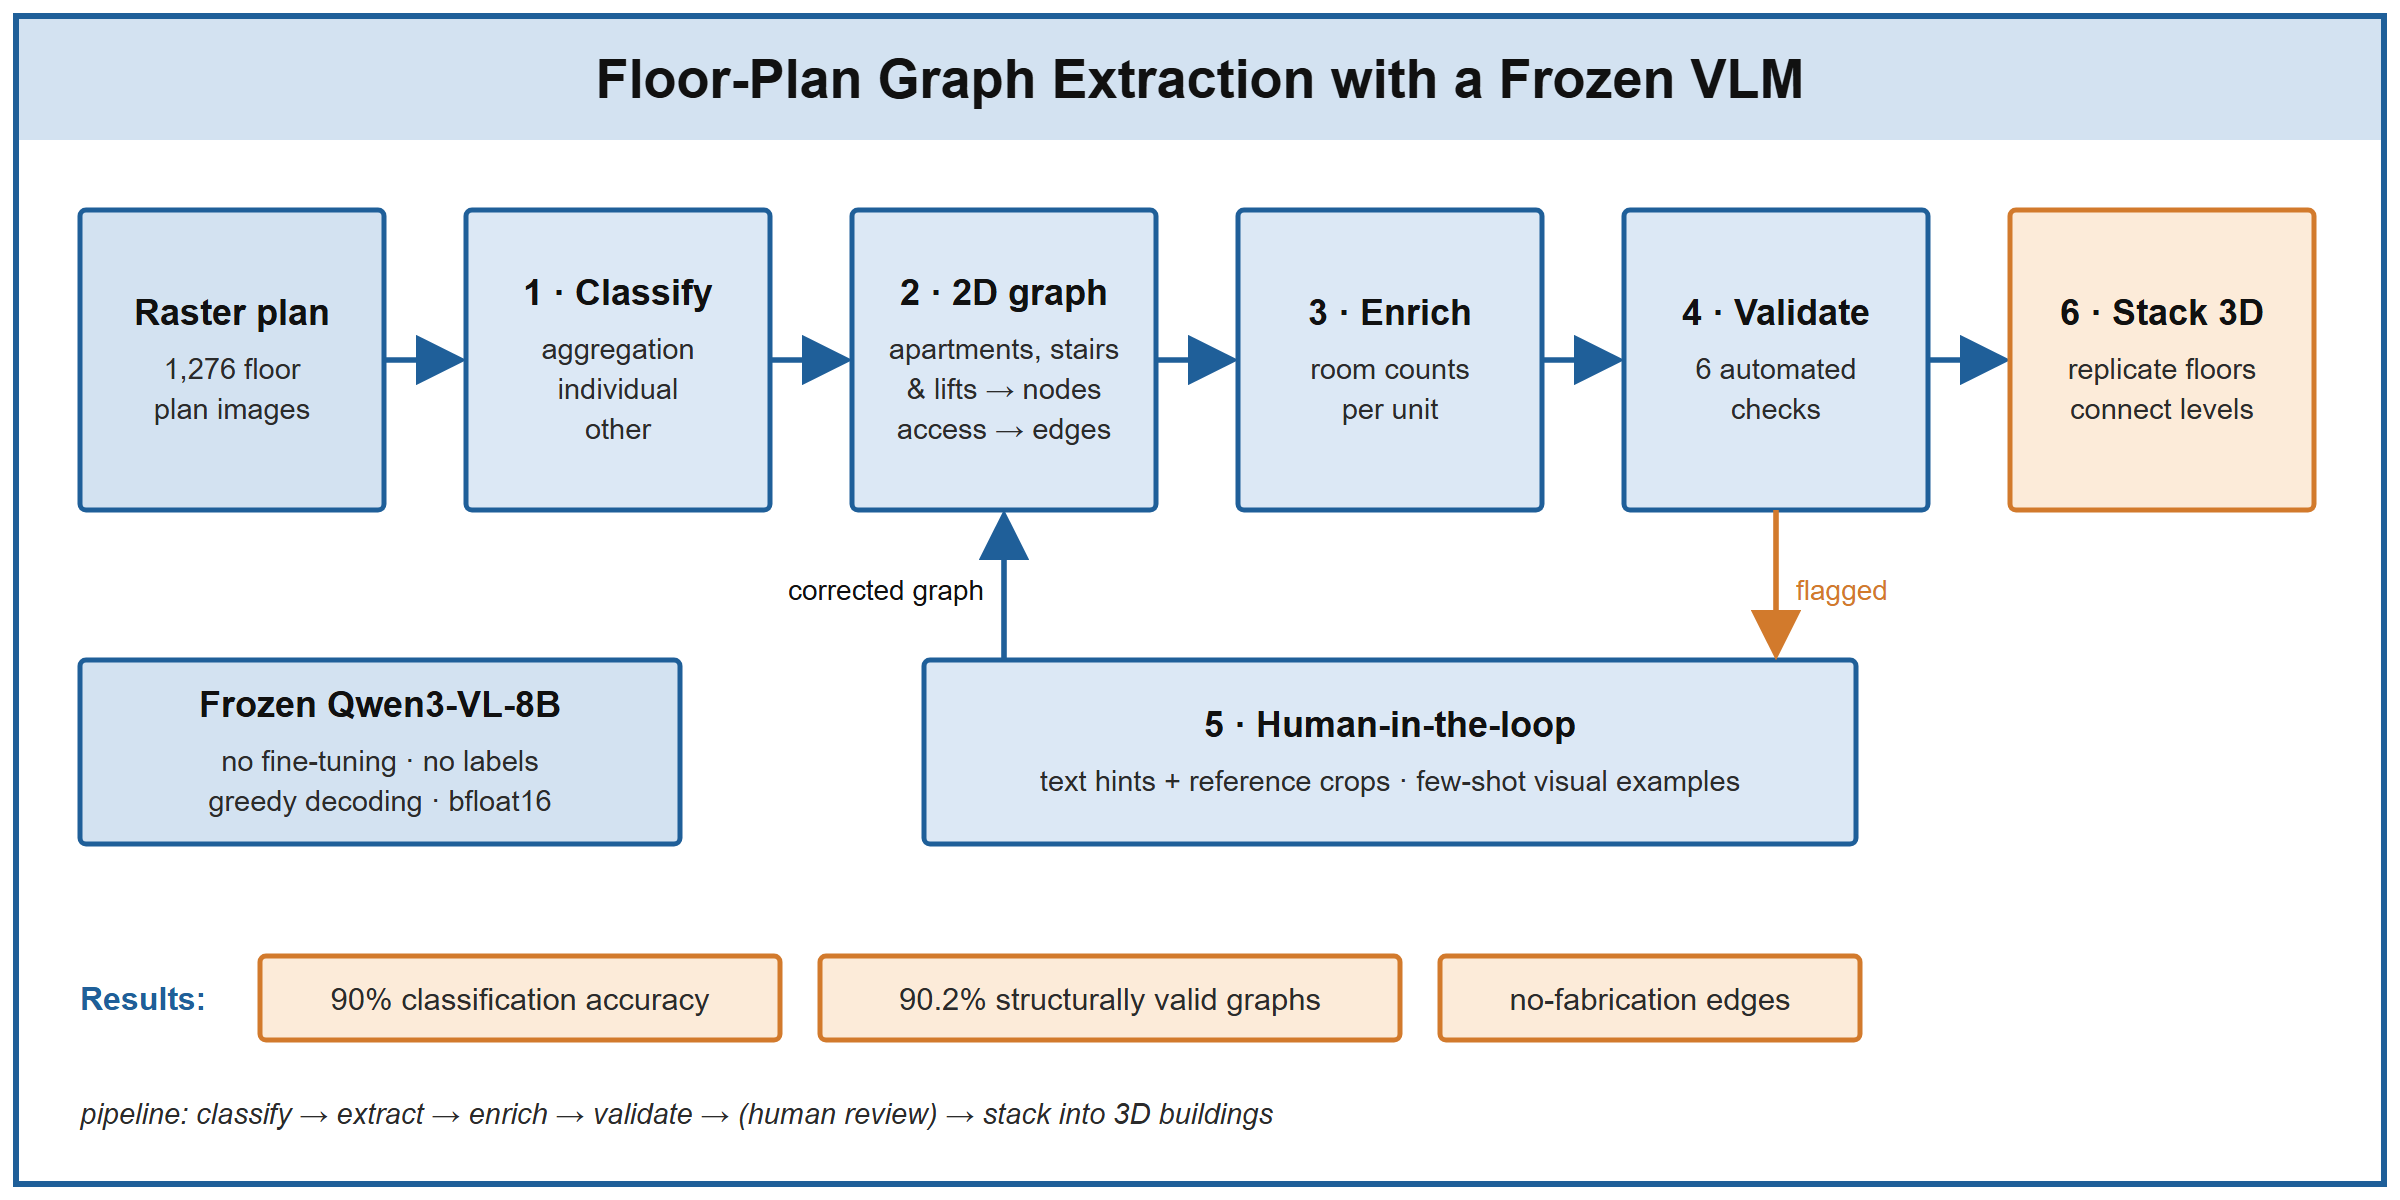
Annotation-free pipeline turning 1,276 raster floor plans into topological graphs with a frozen VLM — 90.2% structurally valid.Pipeline sin anotaciones que convierte 1.276 planos en grafos topológicos con un VLM congelado — 90,2% estructuralmente válidos.Pipeline sense anotacions que converteix 1.276 plànols en grafs topològics amb un VLM congelat — 90,2% estructuralment vàlids.免标注流水线,用冻结的 VLM 将 1,276 张户型图转为拓扑图——90.2% 结构有效。
Qwen3-VLVLMsPrompt EngineeringPyTorch
HighlightsPuntos clavePunts clau要点
Annotation-free pipeline converting 1,276 raster floor plans into structured topological graphs with a frozen VLM (Qwen3-VL-8B) — no fine-tuning, no labels.
Pipeline sin anotaciones que convierte 1.276 planos ráster en grafos topológicos con un VLM congelado (Qwen3-VL-8B), sin fine-tuning ni etiquetas.
Pipeline sense anotacions que converteix 1.276 plànols ràster en grafs topològics amb un VLM congelat (Qwen3-VL-8B), sense fine-tuning ni etiquetes.
Six-stage prompting strategy reaching 90% classification accuracy and structurally valid graphs for 90.2% of plans; built an automated validation framework and human-in-the-loop refinement.
Estrategia de prompting en seis etapas con 90% de precisión y grafos válidos en el 90,2% de los planos; marco de validación automático y refinamiento human-in-the-loop.
Estratègia de prompting en sis etapes amb un 90% de precisió i grafs vàlids en el 90,2% dels plànols; marc de validació automàtic i refinament human-in-the-loop.
pipeline — classify → 2D graph → enrich → validate (human-in-the-loop for flagged graphs) → stack 3D · frozen Qwen3-VL-8B
Qwen3 + LoRAone LLM for forecasting and synthetic dataun LLM para previsión y datos sintéticosun LLM per a previsió i dades sintètiques一个 LLM 同时做预测与合成数据
gen-ai
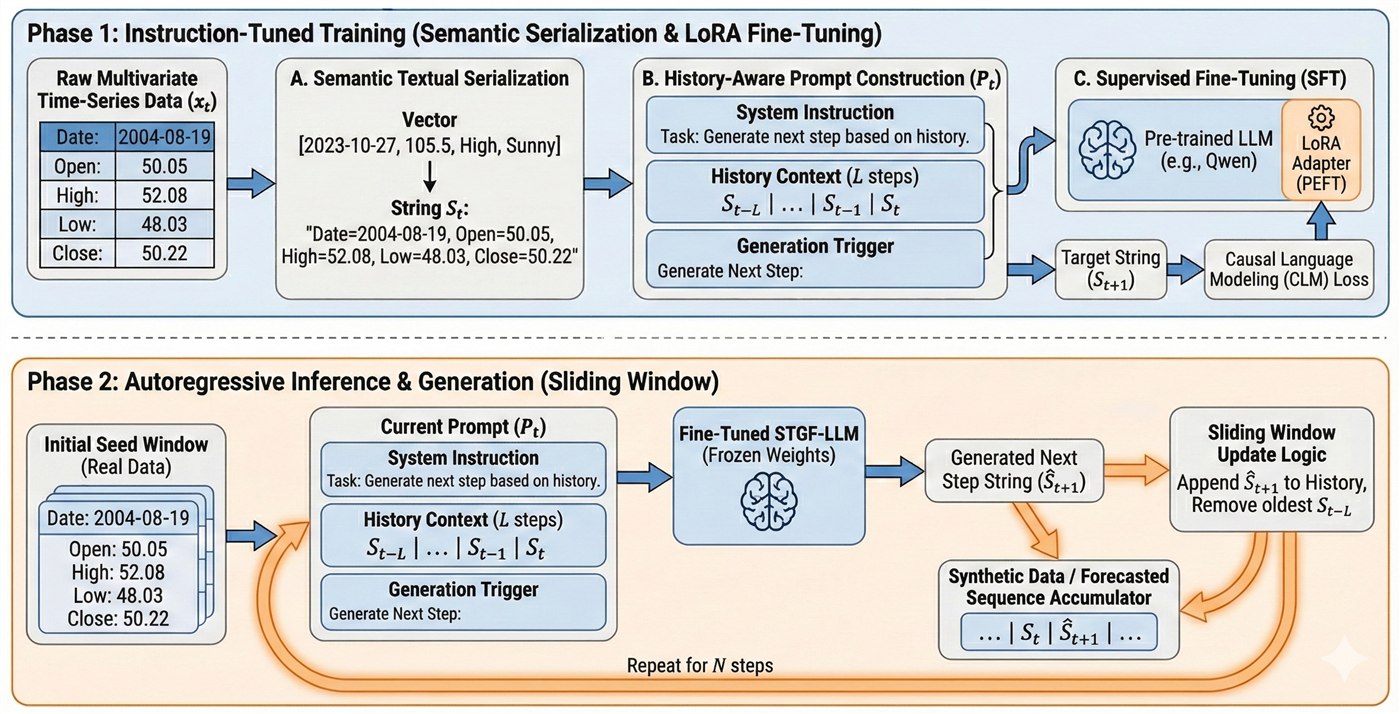
Fine-tuned Qwen3 with history-aware prompting for time-series forecasting and synthetic data, benchmarked against TimeGAN and Chronos-T5.Fine-tuning de Qwen3 con prompting history-aware para previsión de series temporales y datos sintéticos, comparado con TimeGAN y Chronos-T5.Fine-tuning de Qwen3 amb prompting history-aware per a previsió de sèries temporals i dades sintètiques, comparat amb TimeGAN i Chronos-T5.以历史感知提示微调 Qwen3,用于时序预测与合成数据生成,并与 TimeGAN、Chronos-T5 对比。
Qwen3LLMsGenerative AITime-Series
HighlightsPuntos clavePunts clau要点
Fine-tuned an LLM (Qwen3) for robust time-series forecasting and high-fidelity synthetic data generation, with a history-aware prompting strategy to serialize multivariate temporal data.
Fine-tuning de un LLM (Qwen3) para previsión de series temporales y generación sintética de alta fidelidad, con prompting "history-aware" para datos temporales multivariantes.
Fine-tuning d'un LLM (Qwen3) per a previsió de sèries temporals i generació sintètica d'alta fidelitat, amb prompting "history-aware" per a dades temporals multivariants.
150k+Steam records → satisfaction predictionregistros de Steam → predicción de satisfacciónregistres de Steam → predicció de satisfacció条 Steam 记录 → 满意度预测
mlops
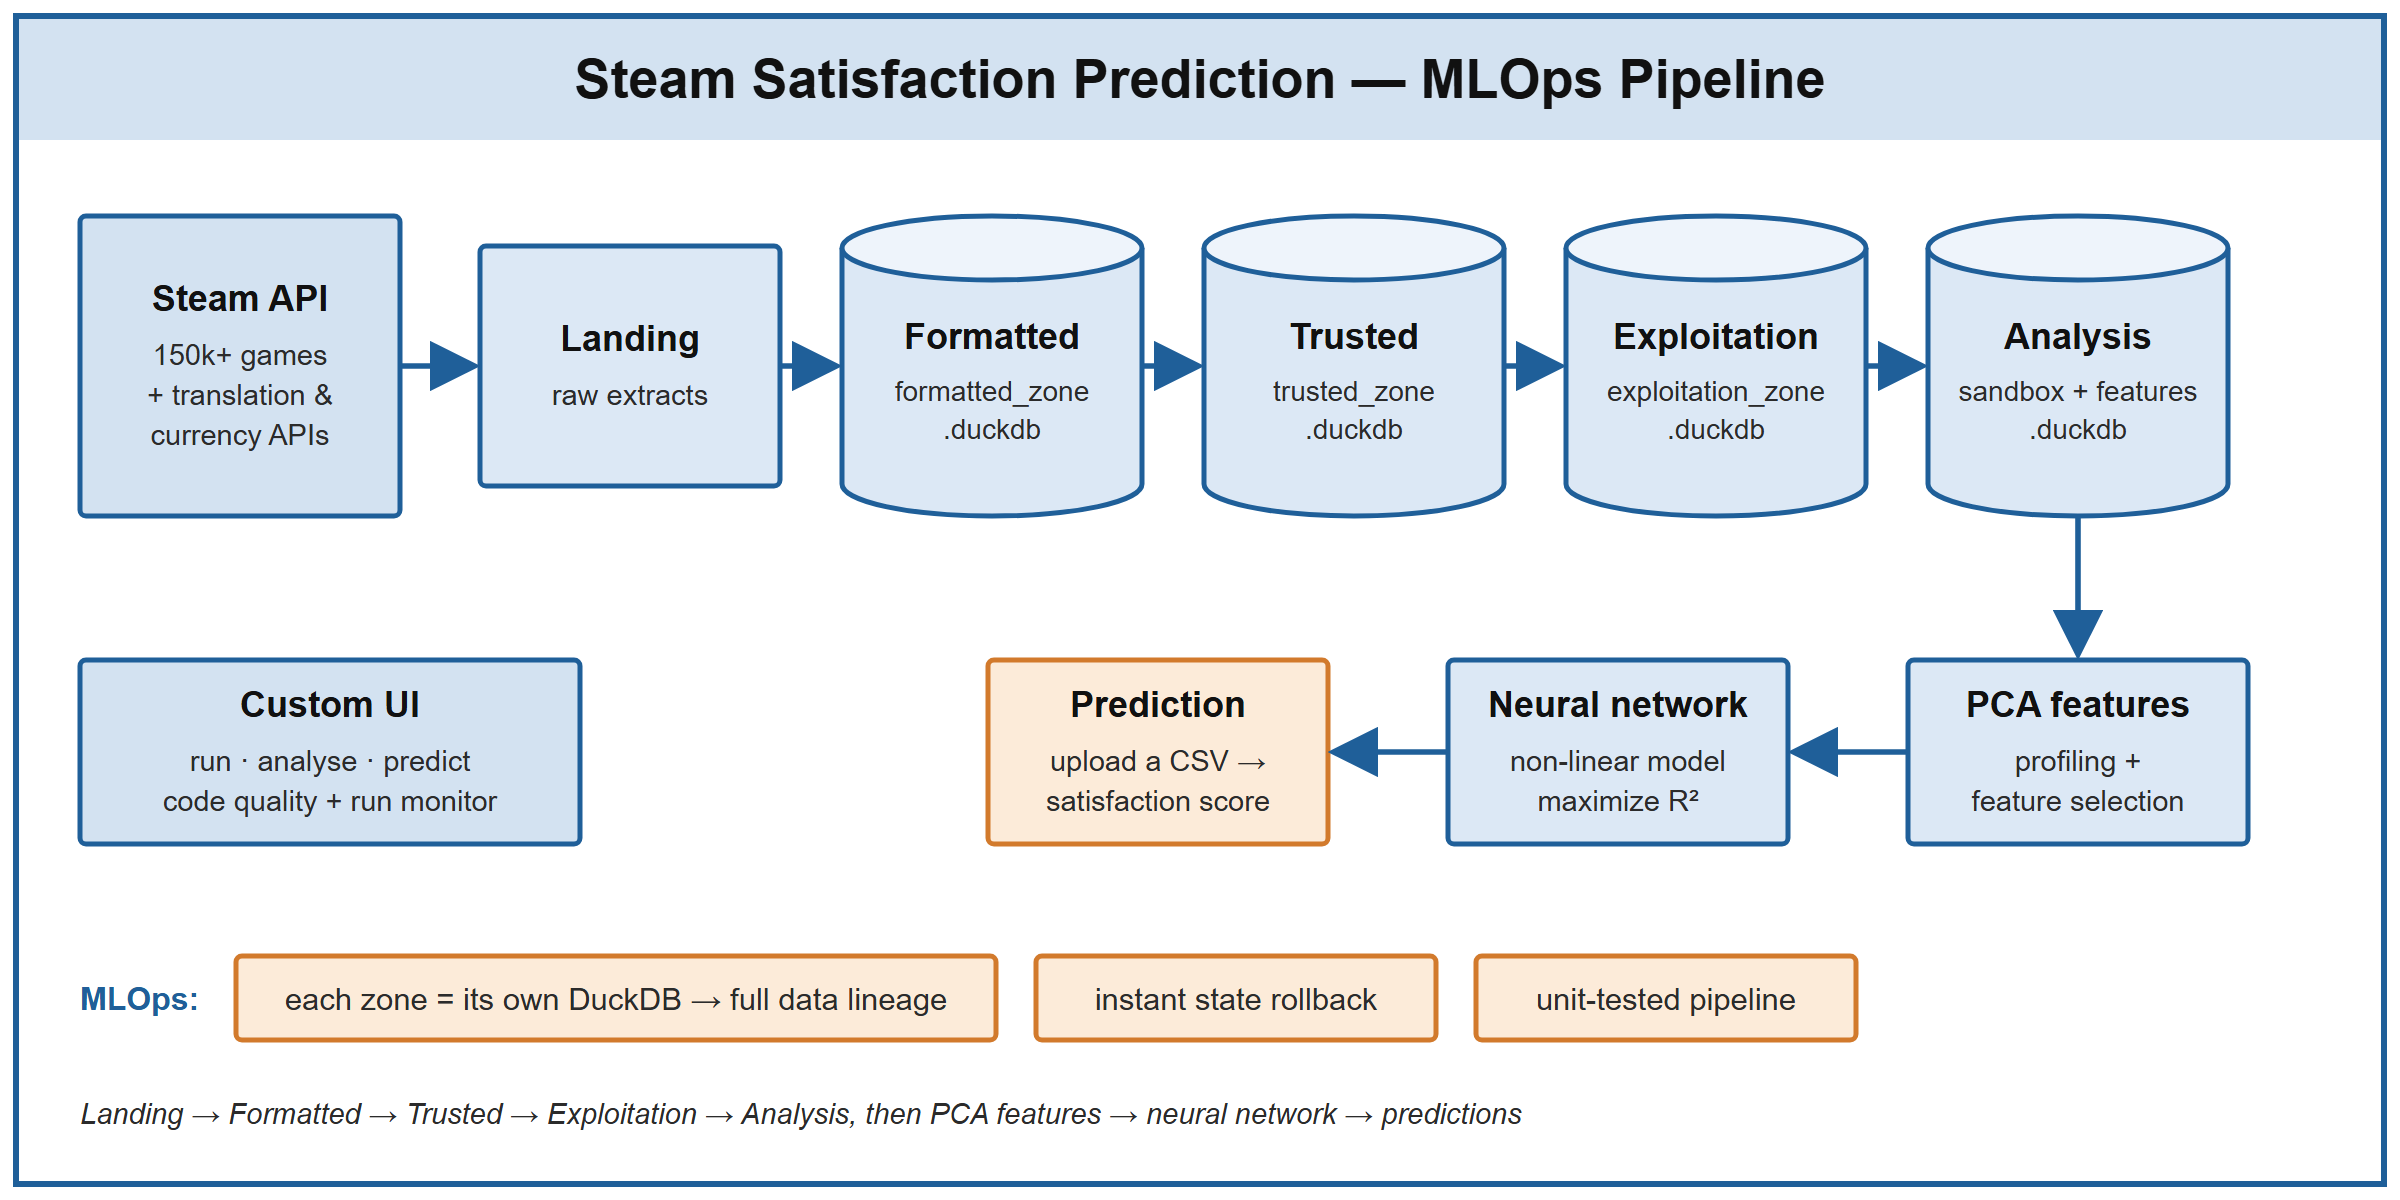
Predicts player satisfaction from 150k+ Steam records with PCA and a custom neural network, run as an MLOps pipeline with DuckDB lineage.Predice la satisfacción de jugadores desde 150k+ registros de Steam con PCA y una red neuronal, como pipeline MLOps con linaje en DuckDB.Prediu la satisfacció de jugadors a partir de 150k+ registres de Steam amb PCA i una xarxa neuronal, com a pipeline MLOps amb llinatge a DuckDB.基于 15 万+ Steam 记录,用 PCA 与定制神经网络预测玩家满意度,并以带 DuckDB 血缘的 MLOps 流水线运行。
PyTorchPCADuckDBMLOps
HighlightsPuntos clavePunts clau要点
Full ML pipeline on 150,000+ Steam API records: profiling, PCA feature selection, and a custom neural network to maximize predictive R².
Pipeline ML completo sobre 150.000+ registros de Steam: profiling, selección de variables con PCA y una red neuronal a medida para maximizar el R².
Pipeline ML complet sobre 150.000+ registres de Steam: profiling, selecció de variables amb PCA i una xarxa neuronal a mida per maximitzar l'R².
在 15 万+ Steam API 记录上的完整 ML 流水线:数据分析、PCA 特征选择、定制神经网络最大化预测 R²。
MLOps pipeline with DuckDB for full data lineage and instant rollback, plus a custom UI for automated execution and monitoring.
Pipeline MLOps con DuckDB para linaje completo y rollback instantáneo, con UI para ejecución y monitorización.
Pipeline MLOps amb DuckDB per a llinatge complet i rollback instantani, amb UI per a execució i monitoratge.
167champions analysed with PCA, MDS, MCA, clustering and classificationpersonajes analizados con PCA, MDS, MCA, clustering y clasificaciónpersonatges analitzats amb PCA, MDS, MCA, clustering i classificació名英雄,用 PCA、MDS、MCA、聚类与分类方法分析
statistics · R
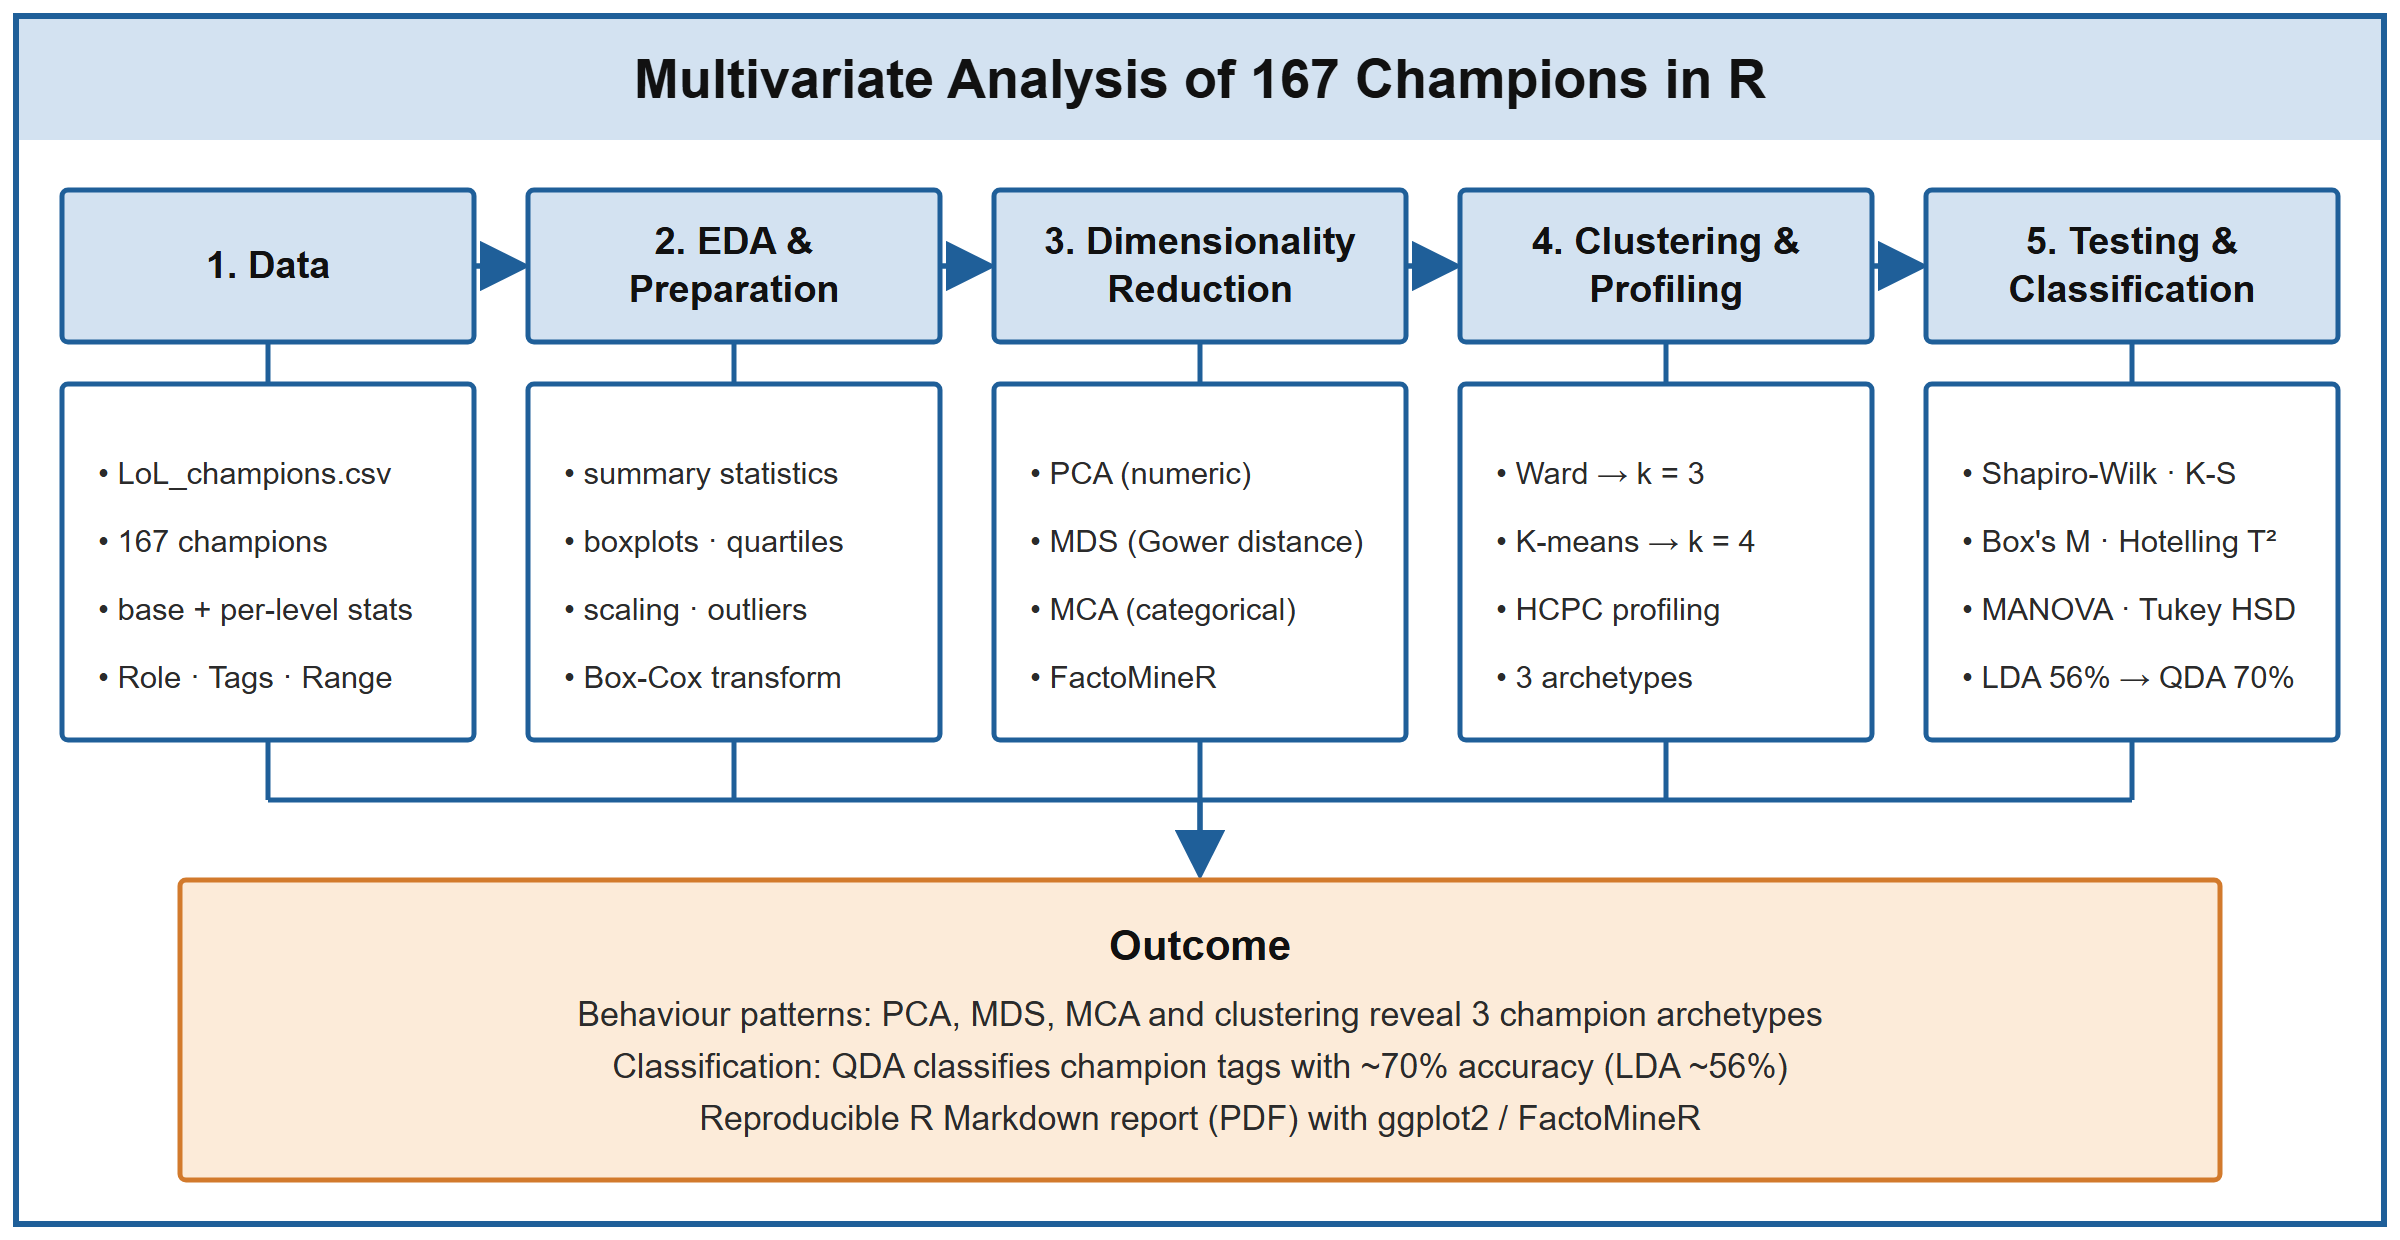
Explores how 167 champions behave in R with PCA, MDS, MCA and clustering, then ends with classification — QDA reaches ~70% accuracy.Explora el comportamiento de 167 personajes en R con PCA, MDS, MCA y clustering, y termina con clasificación: QDA alcanza ~70% de acierto.Explora el comportament de 167 personatges en R amb PCA, MDS, MCA i clustering, i acaba amb classificació: QDA arriba a un ~70% d'encert.在 R 中用 PCA、MDS、MCA 与聚类分析 167 名英雄的不同行为特征,最后进行分类——QDA 准确率约 70%。
RPCAMDSFactoMineR+1
HighlightsPuntos clavePunts clau要点
Analyzed the behaviour of 167 game characters across base and growth statistics in R, comparing analytic methods — PCA, MDS, MCA and cluster analysis (Ward, k = 3) — to uncover the structure, similarities and groups in the dataset.
Analicé el comportamiento de 167 personajes según estadísticas base y de crecimiento en R, comparando métodos analíticos —PCA, MDS, MCA y análisis de clústeres (Ward, k = 3)— para descubrir la estructura, las similitudes y los grupos del dataset.
Vaig analitzar el comportament de 167 personatges segons estadístiques base i de creixement en R, comparant mètodes analítics —PCA, MDS, MCA i anàlisi de clústers (Ward, k = 3)— per descobrir l'estructura, les semblances i els grups del dataset.
用 R 分析 167 名角色在基础与成长属性上的不同行为,比较 PCA、MDS、MCA 与聚类分析(Ward,k = 3)等方法,揭示数据集的结构、相似性与分组。
Finished with classification: hypothesis tests (Hotelling T², MANOVA) selected the predictors, and QDA classified champion tags with ~70% accuracy (vs 56% for LDA); delivered as a reproducible R Markdown report with ggplot2/FactoMineR visualizations.
Terminé con clasificación: contrastes de hipótesis (T² de Hotelling, MANOVA) seleccionaron los predictores y QDA clasificó las etiquetas con ~70% de acierto (frente al 56% de LDA); entregado como informe reproducible en R Markdown con visualizaciones ggplot2/FactoMineR.
Vaig acabar amb classificació: contrastos d'hipòtesis (T² de Hotelling, MANOVA) van seleccionar els predictors i QDA va classificar les etiquetes amb un ~70% d'encert (davant del 56% de LDA); lliurat com a informe reproduïble en R Markdown amb visualitzacions ggplot2/FactoMineR.
pipeline — data → EDA → PCA · MDS · MCA → clustering (Ward, k = 3) → tests → classification (QDA ~70%) · R Markdown report
04 / toolboxherramientaseines工具箱
SkillsHabilidadesHabilitats技能
Tools I've used across work, research and projects — click one to see where.Herramientas que he usado en trabajo, investigación y proyectos — haz clic en una para ver dónde.Eines que he fet servir a la feina, en recerca i en projectes — fes clic en una per veure on.我在工作、研究与项目中使用过的工具——点击查看用在了哪里。
Available immediately · based in Barcelona · open to relocate · Spanish work permit.Disponible de inmediato · en Barcelona · abierto a reubicarme · permiso de trabajo en España.Disponible immediatament · a Barcelona · obert a canviar de ciutat · permís de treball a Espanya.可立即到岗 · 常驻巴塞罗那 · 可考虑搬迁 · 持西班牙工作许可。